Les entreprises qui affrontent la croissance des données connaissent bien la tension entre l’agilité d’un lac de données et la robustesse d’un entrepôt. Ici, il s’agit d’expliquer comment une Architecture Data Lakehouse opère la Fusion de ces mondes pour offrir à la fois Souplesse et Performance sans multiplier les silos.
Architecture Data Lakehouse : comment la fusion du Data Lake et du Data Warehouse change la donne
Le constat est simple : les architectures à deux niveaux génèrent des copies, des latences et des coûts d’exploitation élevés. Dans de nombreuses PME, l’ETL vers un entrepôt se transforme en usine compliquée et chronophage, et les équipes perdent du temps à réconcilier des versions divergentes des mêmes données 📊.
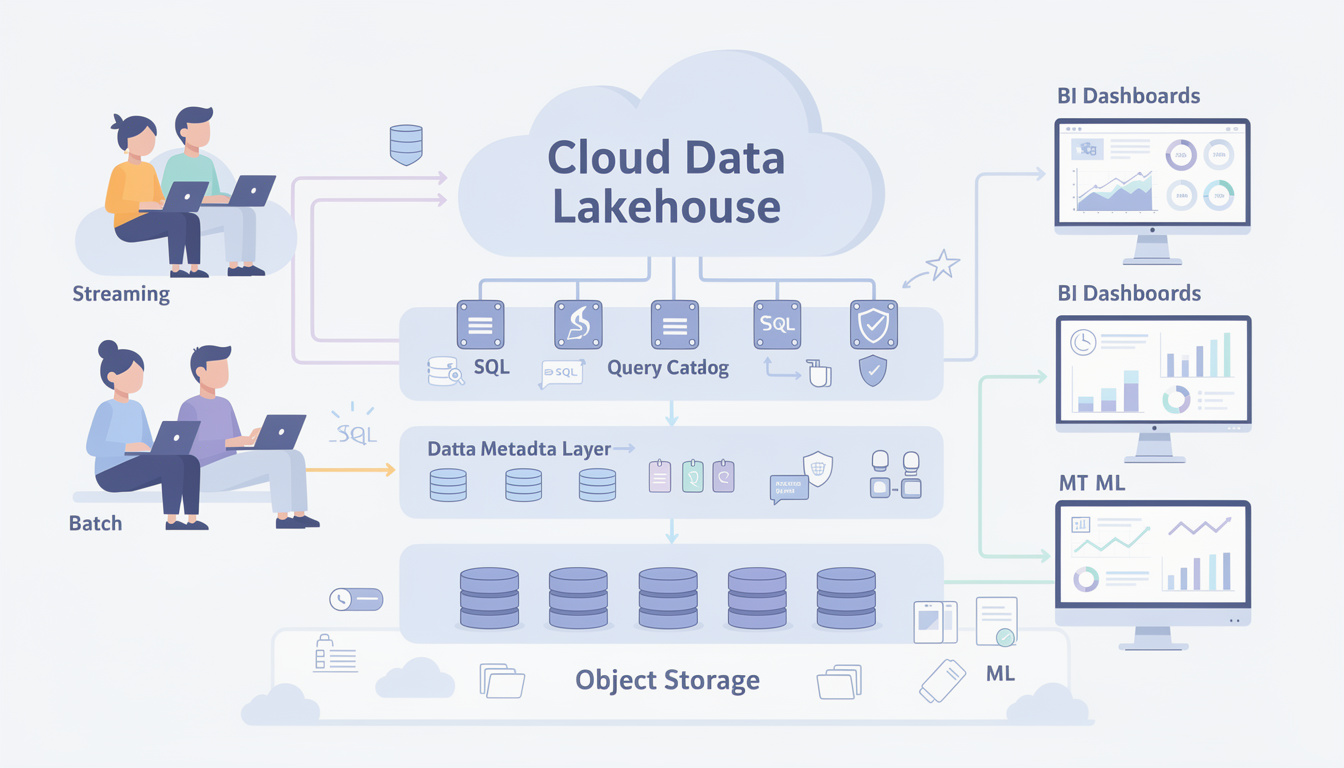
Le Data Lakehouse propose de stocker l’ensemble des données dans un stockage de données économique tout en superposant des couches de gestion des données (métadonnées, transactions ACID, gouvernance). Le résultat : un accès unifié pour la analyse de données, le machine learning et le reporting, avec des données plus fraîches et cohérentes. Insight : c’est la réduction des mouvements de données qui libère vraiment du temps métier.
Les origines techniques et pourquoi elles comptent pour votre projet
Trois avancées rendent le lakehouse opérationnel : les couches de métadonnées (Delta/Iceberg), les moteurs de requête optimisés pour SQL sur objets, et l’intégration native des outils ML. Ces composants réduisent la nécessité d’utiliser plusieurs systèmes et accélèrent l’accès pour tous les profils, du data analyst au data scientist.
Concrètement, les métadonnées permettent les transactions ACID sur du Data Lake brut et le time travel pour la reproductibilité des modèles. Insight : la valeur se mesure par la fiabilité des résultats, pas seulement par la volumétrie stockée.
Technologies clés de l’Architecture Data Lakehouse et leurs bénéfices pour une PME
Les formats ouverts comme Parquet, combinés à des métastores (Iceberg, Delta) et à des moteurs SQL vectorisés, offrent une performance proche des entrepôts traditionnels sur de grands jeux de données. Cela signifie que l’on peut exécuter des rapports business critiques sans déplacer les données 📈.
La séparation du calcul et du stockage via des magasins d’objets permet d’adapter les ressources selon les charges, ce qui réduit les coûts. Insight : la flexibilité se paie en pratique par une facturation cloud plus maîtrisée, si l’on sait dimensionner correctement.
Organisation et pièges techniques à anticiper
Construire un lakehouse « from scratch » demande une compétence d’ingénierie non négligeable. Beaucoup d’équipes optent pour une solution managée afin d’éviter la dette opérationnelle et d’assurer la gouvernance en continu. Dans une PME, le choix influence directement la capacité à délivrer des cas d’usage ML et BI utiles rapidement 🚧.
Il faut aussi prévoir la gouvernance : contrôle d’accès, catalogage des données et policies de qualité. Sans cela, le lakehouse redevient vite un lac sans rives. Insight : la technologie seule ne suffit pas, la gouvernance reste le moteur de la confiance.
Cas pratique : comment une PME a réduit la duplication et gagné en vélocité avec un Data Lakehouse
Dans une PME de distribution, les rapports quotidiens prenaient plusieurs heures à générer et les data scientists récréaient constamment des jeux de données. Après la mise en place d’un lakehouse, les pipelines ETL ont été simplifiés et les équipes ont travaillé sur une source unique pour l’analyse de données et le ML.
Résultat : les temps d’itération sur les modèles sont passés de semaines à jours, et le service financier a retrouvé des chiffres cohérents pour prendre des décisions. Insight : la centralisation maîtrise les coûts et accélère l’expérimentation.
Étapes pratiques pour démarrer votre projet sans créer de nouvelle dette
Commencer par cartographier les sources de données et choisir un stockage de données objet adapté. Ensuite, tester un moteur open source (Iceberg/Delta) sur un périmètre restreint pour valider les performances et la gouvernance.
Enfin, intégrer progressivement les outils BI et ML directement sur le lakehouse afin d’éviter la duplication. Insight : piloter l’adoption par cas d’usage concrets garantit un retour sur investissement visible et durable ✨.
Limites et défis de l’Architecture Data Lakehouse en 2026
Le lakehouse ne supprime pas la complexité, il la déplace : orchestration, monitoring et gestion des coûts cloud deviennent centraux. Les organisations mal préparées risquent de rencontrer une montée en complexité opérationnelle plutôt qu’une simplification.
Par ailleurs, l’interopérabilité doit être pensée dès le départ pour éviter un verrouillage technologique. Insight : privilégier des standards ouverts et une gouvernance claire protège l’agilité sur le long terme.
Derniers conseils opérationnels pour une mise en place pragmatique
Valider le périmètre métier, choisir des formats ouverts, automatiser la qualité des données et documenter le catalogue sont des gestes simples qui changent beaucoup de choses. Penser en termes d’usage (BI, ML, reporting) plutôt qu’en technologies seules facilite les arbitrages.
Si la contrainte technique est forte, privilégier une offre managée pour démarrer et migrer ensuite vers une solution plus personnalisée si nécessaire. Insight : la méthode prime sur l’outil — avancez par itérations contrôlées et mesurables 🔎.

