Un cas fréquent chez les petites plateformes e‑commerce : des pics de trafic qui mettent à genoux la base de données, des pages lentes et des clients qui abandonnent leur panier. Ce texte explique, avec des exemples concrets, comment une caching stratégique associant Redis et Varnish permet d’assurer la haute disponibilité et d’améliorer la performance des sites web.
Caching stratégique : Redis et Varnish pour des sites web à haute disponibilité
Le problème de départ est simple : les mêmes données sont demandées des milliers de fois et la base de données finit par devenir le goulot d’étranglement. En mettant une couche de mise en cache en amont, on réduit les requêtes coûteuses, on améliore le temps de réponse et on gagne en scalabilité.
Dans un projet récent pour une PME du vêtement en ligne, la mise en place progressive d’un cache HTTP avec Varnish devant les serveurs applicatifs et d’un cache en mémoire avec Redis pour les sessions et fragments métier a divisé le TTFB par deux et supporté des pics 5x supérieurs sans augmentation linéaire des coûts. ⚡️
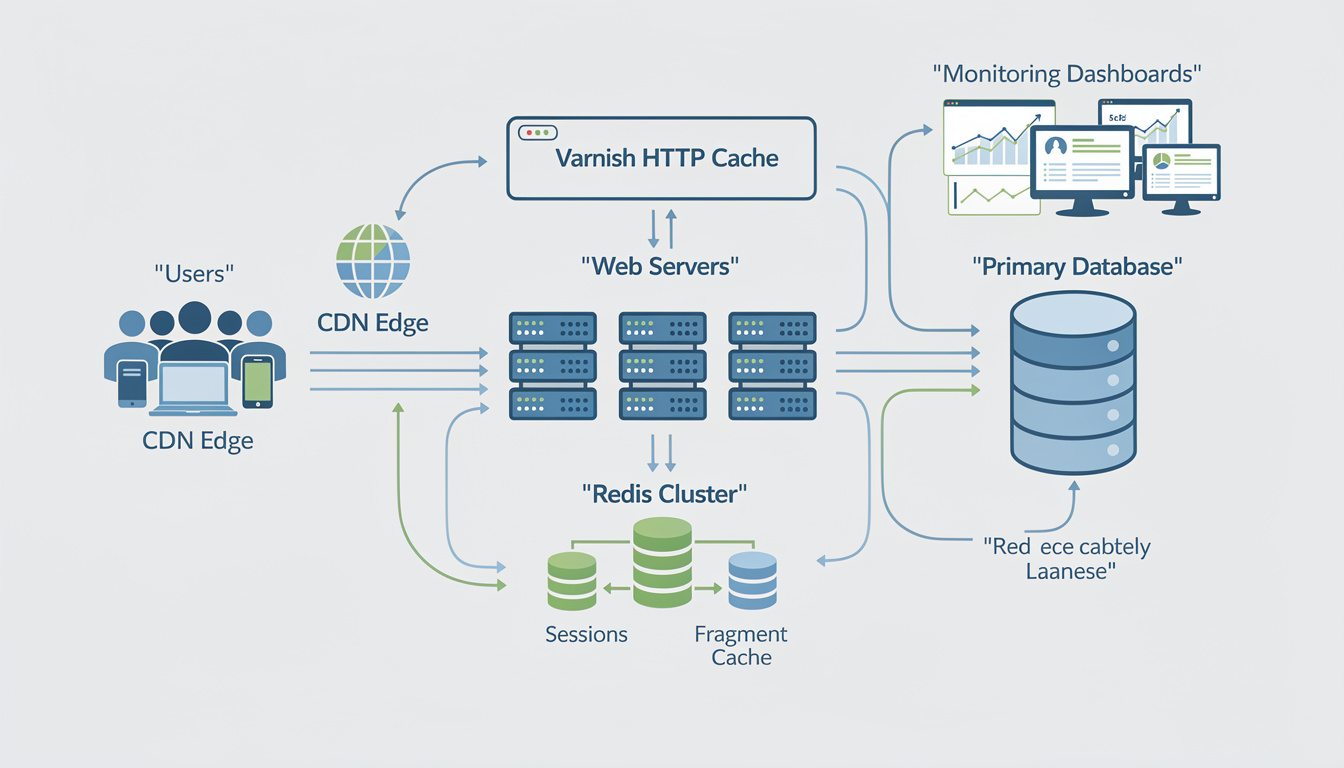
Schématiser l’architecture aide à prendre les décisions techniques et opérationnelles nécessaires pour viser la haute disponibilité. Insight : choisir les rôles exacts de Redis et Varnish évite les doublons et maximise l’efficacité du cache.
Redis : accélérer les accès métiers et maintenir la résilience
Pour l’application métier, Redis n’est pas seulement un cache clé‑valeur : il offre des listes, des hachages, des ensembles et des mécanismes de pub/sub qui servent aussi bien la gestion de session que des files de tâches. En pratique, Redis a servi à stocker le catalogue produit fréquemment lu, les pages « quick view » et les sessions utilisateur, ce qui a allégé la base primaire lors des promotions.
Depuis 2024, l’évolution des usages a même permis d’exploiter Redis en tant que brique sémantique et magasin vectoriel pour enrichir la recherche produit ; pour approfondir cet aspect, la lecture sur bases de données vectorielles apporte un bon complément. 🔍
Sur le plan opérationnel, viser la haute disponibilité implique d’activer Redis Sentinel ou Redis Cluster, de planifier la persistence adaptée et de dimensionner la mémoire selon la volée métier. Insight : la flexibilité des structures Redis permet d’optimiser la logique métier tout en gardant un accès ultra-rapide aux données critiques.
La vidéo ci‑dessus illustre des patterns d’usage concrets pour intégrer Redis dans une API et gérer l’expiration. Après l’avoir regardée, l’étape suivante est de définir quels objets doivent être persistants ou éphémères.
Varnish : réduire le TTFB et soulager l’infrastructure web
Varnish se place en frontal HTTP pour servir des pages ou fragments mis en cache avant qu’ils n’atteignent l’application. Sur des pages produit avec contenu majoritairement statique mais personnalisable (prix, disponibilité), Varnish permet de délivrer un HTML déjà rendu et de réduire significativement le temps de réponse. 🚀
L’amélioration du TTFB s’inscrit dans une optimisation plus large des performances ; pour comprendre l’impact mesurable sur le délai d’affichage, ce guide pratique sur temps de réponse et TTFB est utile. En test réel, la mise en place de Varnish devant des backends Nginx a réduit le TTFB de 40 à 60 % selon les pages.
Sur le plan des règles d’invalidation, Varnish accepte des purges ciblées et des stratégies basées sur des headers, ce qui facilite la coordination avec la couche Redis. Insight : placer Varnish en front et Redis en cache applicatif maximise la couverture fonctionnelle et la réduction des latences.
Cette seconde ressource vidéo montre comment écrire des VCL simples pour contrôler les politiques de cache et protéger l’application des « cache stampedes » lors des expirations massives. Après visionnage, il est pertinent d’expérimenter des TTL progressifs et des purges taguées.
Déploiement, haute disponibilité et stratégies d’invalidation
Penser la scalabilité commence par définir des scénarios de défaillance : que se passe‑t‑il si Redis est indisponible, si Varnish purge masivement, ou si la base explose sous le load ? La réponse consiste à articuler modes de repli et redondance, par exemple : Redis Cluster multi‑AZ, Varnish en pool derrière un load balancer et un CDN pour soulager le front.
La mise en cache doit être pilotée par des règles d’invalidation claires : TTL adaptés, invalidation basée sur événements métiers et purges ciblées. Pour éviter l’effet d’horodatage (thundering herd), mettre en œuvre un verrouillage léger qui laisse une requête rafraîchir le cache pendant que les autres continuent à servir l’ancienne valeur atténue la surcharge. ⚠️
Sur la sécurité et la maintenance, chiffrer les accès au cache, limiter les droits et automatiser les sauvegardes évitent des surprises opérationnelles. Insight : la robustesse n’est pas qu’une question d’infrastructure, c’est une succession de règles opérationnelles et de tests.
Mesures de performance et optimisation continue
Mesurer pour agir : le taux de réussite du cache, le temps de réponse moyen, l’utilisation CPU des backends et la charge DB sont des indicateurs clés. Une campagne de tests de charge avant une promo révèle rapidement si le caching stratégique tient ses promesses et où il faut ajuster les TTL ou la taille du cache.
Sur le terrain, la surveillance continue a permis à une équipe de détecter une baisse de hit rate liée à une mauvaise clé de cache après un déploiement ; corriger la clé a restauré la performance en quelques minutes. Insight : instrumenter dès le départ permet de transformer un incident en apprentissage.
Itérer sur la stratégie : prioriser, tester, automatiser
La bonne pratique consiste à commencer par mettre en cache les objets les plus consultés et les moins volatils, puis à élargir. L’automatisation des purges lors d’événements métiers (mise à jour d’un produit, changement de stock) maintient la cohérence sans intervention manuelle.
Enfin, documenter les choix de cache, les politiques TTL et les scénarios de repli transforme une configuration fragile en un système maintenable. Insight : une stratégie documentée et testée permet d’atteindre l’équilibre entre performance, cohérence et coûts.

