Résumé : cet article détaille une conception étape par étape pour passer d’un système monolithique à une architecture microservices pensée pour une infrastructure scalable. Le fil conducteur est celui d’une entreprise fictive, Fabrikam, qui illustre les décisions techniques et organisationnelles à chaque étape. 🔍
Architecture microservices : définition et principes clés pour une infrastructure scalable
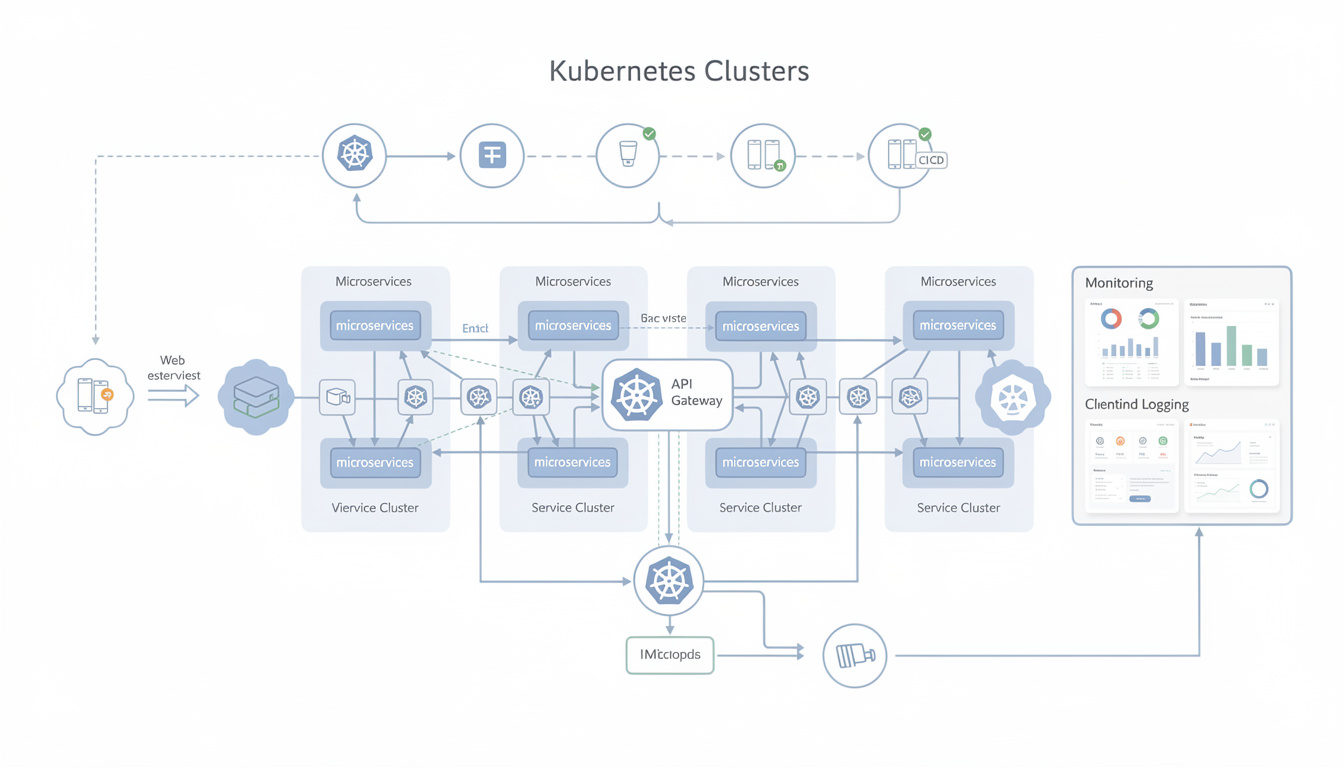
La architecture microservices consiste à fragmenter une application en services autonomes qui communiquent via des API. Chaque service gère une capacité précise, ce qui permet une scalabilité horizontale fine et une tolérance aux pannes ciblée.
En pratique, cela signifie privilégier des conteneurs pour la portabilité, un orchestrateur pour maintenir l’état désiré et une stratégie claire pour la gestion des services. 📈
Insight : bien pensée, une architecture microservices transforme des coûts fixes lourds en capacités ajustables là où la charge le demande.
Découper le système : conception étape par étape et modélisation métier
La première étape est l’analyse du domaine fonctionnel : identifier les frontières naturelles entre les capacités (commande, paiement, catalogue, notification). Pour Fabrikam, la séparation entre planification de drone, suivi des colis et facturation a servi de point de départ. ✂️
La conception étape par étape recommande de commencer par des services faiblement couplés, puis d’appliquer le modèle Fig Strangler pour migrer progressivement le monolithe. Un découpage mal pensé crée un « monolithe déguisé » ; la règle d’or reste la cohérence des frontières métiers. 🔁
Insight : segmenter par domaine métier réduit les risques de dépendances croisées et facilite le test ciblé des nouveaux services.
Orchestration, déploiement microservices et automatisation du déploiement
L’orchestration est le cœur opérationnel : Kubernetes (ou des offres managées comme AKS) prend en charge l’équilibrage, la remise en service et l’autoscaling. Pour certains services peu critiques, des fonctions serverless peuvent réduire la surcharge opérationnelle. ⚙️
Automatiser le pipeline de déploiement est indispensable : CI/CD, tests d’intégration, canary releases et rollback automatisé limitent l’impact des erreurs. L’automatisation du déploiement raccourcit les cycles et sécurise les mises en production.
Insight : sans une chaîne d’outils d’automatisation solide, la promesse de rapidité des microservices se transforme en chaos opérationnel.
Communication interservices, gestion des services et tolérance aux pannes
La communication interservices doit combiner approches synchrones (REST/gRPC) et asynchrones (messagerie, events). Le choix dépend des contraintes de latence et de cohérence ; pour Fabrikam, le suivi en temps réel s’appuie sur des événements, tandis que la facturation conserve des appels synchrones. 🔗
Les passerelles API et les meshes facilitent la gestion des services en centralisant l’authentification, la limitation de débit et l’observabilité. Les patterns comme Ambassadeur ou Circuit Breaker renforcent la tolérance aux pannes. Un monitoring fin et des SLO clairement définis complètent l’arsenal.
Insight : la robustesse vient d’un duo technique-organisationnel : protocoles adaptés et conventions d’équipe pour garantir la résilience.
Pour un retour d’expérience technique approfondi, cet article sur l’architecture et la croissance technique illustre des cas concrets et décisions d’ingénierie. Pour comprendre les choix d’organisation derrière la technique, lire aussi ce retour d’expérience sur la structuration d’équipes. 📚
Considérations sur les données, cohérence et modèles opérationnels
Chaque service doit posséder son modèle de données pour limiter les verrouillages. Cela impose de repenser la cohérence : transactions distribuées, compensation et événements garantissent l’intégrité sans sacrifier la disponibilité. 🧩
Le choix des magasins (NoSQL pour l’historique, bases relationnelles pour la facturation) dépend des besoins d’accès et des patterns d’usage. Documenter ces décisions prévient des retours en arrière coûteux.
Insight : adopter des modèles de données adaptés réduit la dette technique et simplifie la montée en charge.
Organisation, compétences et montée en charge des équipes
Le passage aux microservices exige une transformation des équipes : squads autonomes, compétences DevOps et responsabilités élargies sur l’exploitation. La formation et l’accompagnement sont des investissements structurants. 🎯
Le modèle des « two-pizza teams » d’Amazon illustre l’efficacité de petites unités autonomes. Chez Fabrikam, cette organisation a réduit les délais de livraison des features et amélioré la gestion des services au quotidien.
Insight : investir sur les compétences et la gouvernance est aussi décisif que le choix technologique.
Perspectives : cloud-native, edge et scalabilité horizontale
La tendance pour 2026 est claire : cloud-native combiné à de l’edge computing là où la latence est critique. L’orchestration hybride (cloud/edge) et l’optimisation des points de présence permettent d’augmenter la réactivité client. 🌐
La scalabilité horizontale reste la mécanique centrale : ajouter des instances de service plutôt que monolithes massifs permet d’ajuster les coûts et la performance en continu.
Insight : anticiper l’edge et le cloud hybride prépare l’architecture aux usages clients les plus exigeants sans multiplier la complexité.

