Pourquoi les cartes graphiques professionnelles GPU NVIDIA RTX série 6000 sont désormais incontournables pour le rendu architectural 🏛️
Le paysage de la visualisation 3D pour l’architecture a évolué rapidement : il ne s’agit plus seulement d’images séduisantes, mais d’environnements interactifs, de simulations physiques et d’outils d’IA intégrés qui accélèrent le cycle de conception. Dans ce contexte, la génération RTX série 6000 s’impose comme une réponse technique et opérationnelle. Elle combine une mémoire importante, des cœurs spécialisés et des capacités logicielles qui transforment le rapport coût/temps pour les cabinets.
Pour illustrer, prenons le cas fictif d’Atelier Archéa, une PME d’architecture qui conçoit projets résidentiels et tertiaires. Avant la migration vers des stations équipées de GPU NVIDIA RTX série 6000, les rendus photoréalistes et les itérations sur les maquettes BIM imposaient des files d’attente longues et des coûts de cloud élevés. Après intégration, la capacité mémoire et la vitesse de calcul ont réduit ces cycles et permis d’explorer des variantes de conception plus tôt dans le process.
Techniquement, la série Blackwell (RTX PRO 6000) apporte une combinaison d’éléments : mémoire très rapide (GDDR7 jusqu’à 96 Go pour l’édition serveur), architectures de cœurs dédiés pour le ray tracing et l’IA, ainsi que des optimisations pour la précision FP4. Ces avancées ne sont pas anecdotiques : elles permettent d’exécuter des modèles d’IA générative directement dans les pipelines de design, de réduire la latence lors de la navigation en temps réel dans un modèle et d’augmenter la fidélité des simulations d’éclairage.
Un autre paramètre clé est l’aptitude des cartes à fonctionner en mode datacenter 24/7 grâce au format passif des éditions serveurs. Pour un atelier qui externalise, cela signifie accès à des instances cloud proches des données, réduisant la mise en réseau et le temps de rendu. La capacité à partitionner un GPU en plusieurs instances isolées (MIG) est une plus-value pour partager une ressource on-premise entre plusieurs designers sans sacrifier la sécurité ou la performance.
Enfin, l’argument écologique entre en jeu. Une carte offrant plus de travail par watt permet de réduire le coût énergétique des rendus massifs. Dans le cadre d’une stratégie long terme, la rentabilité d’un parc se juge autant sur la vitesse que sur la consommation totale : ici, la technologie RTX et l’optimisation matérielle rendent possible une évolution durable des workflows.
Insight : pour une agence de taille moyenne, investir dans des cartes graphiques professionnelles de la série 6000 peut transformer la capacité à livrer des rendus complexes sans augmenter proportionnellement les coûts d’exploitation.
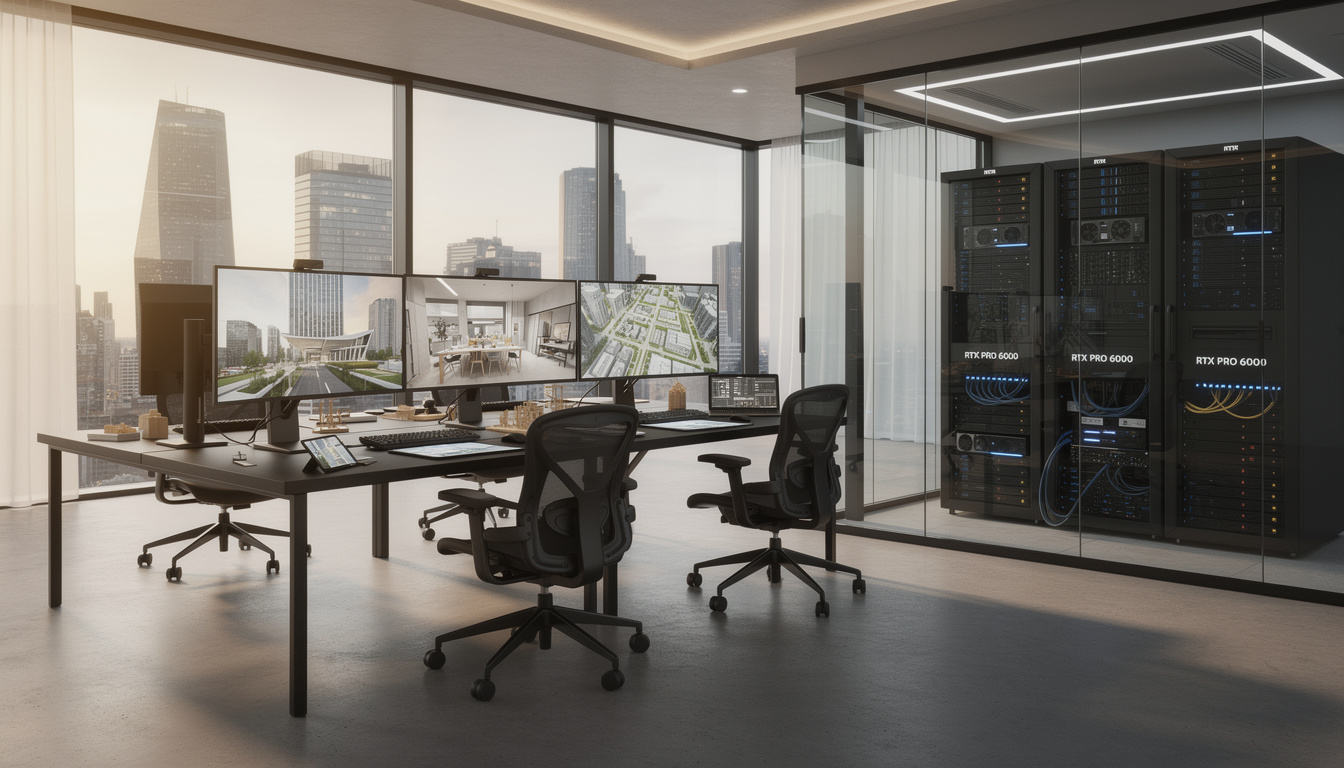
Performances GPU et accélération matériel pour la modélisation architecturale et le ray tracing ✨
Les gains de performances annoncés autour des nouvelles générations ne sont pas uniquement marketing. Les améliorations structurales — plus de cœurs CUDA, des cœurs RT et Tensor de nouvelle génération — se traduisent par des bénéfices concrets : temps de rendu divisé, inférences IA plus rapides et traitement simultané de plusieurs tâches graphiques. Pour l’architecture, cela signifie itérations plus rapides sur les éclairages complexes et rendus physiques en temps proche du réel.
Chiffres clés à retenir : sur certaines charges professionnelles, la série Blackwell permet jusqu’à une multiplication par 2 de la vitesse de rendu par rapport à la génération précédente, et des accélérations encore plus marquées sur les tâches IA (par exemple jusqu’à 5x pour certaines inférences LLM dans des contextes agents). Ces ordres de grandeur se traduisent par journées de travail transformées en demi-journées sur des tâches lourdes de rendu ou de simulation.
Un point technique déterminant est l’apparition de Tensor Cores et d’un Transformer Engine optimisé pour la précision FP4, qui rendent les modèles d’IA générative (texture synthesis, neural rendering) à la fois plus rapides et moins gourmands en mémoire. Pour un studio, l’effet pratique est simple : plus de versions testées, plus d’options explorées avant validation client.
Il faut aussi considérer l’amélioration du pipeline multimédia intégré et des cœurs RT de dernière génération qui permettent un ray tracing en temps réel dans des scènes architecturales denses. Cela n’ôte pas la nécessité de réglages artistiques, mais permet de prendre de meilleures décisions plus tôt, notamment lors de revues clients où la visualisation interactive favorise la prise de décision.
En complément, la série Ada 6000 (RTX 6000 Ada) montre des avancées notables pour les postes de travail : augmentation significative du nombre de cœurs, hausse du débit en single precision et une meilleure efficacité énergétique. Concrètement, cela facilite l’intégration des cartes dans des stations compactes tout en conservant une puissance suffisante pour la modélisation et les rendus rapides.
Insight : les performances GPU modernes convertissent le rendu architectural d’une étape finale coûteuse en un outil d’exploration continue, réduisant le risque de décisions tardives et coûteuses.
Optimiser le workflow architectural : du poste de travail aux plateformes cloud et aux jumeaux numériques 🛠️
Le travail d’architecture moderne s’étend du dessin 2D à la simulation multi-physique et aux jumeaux numériques. La série RTX 6000 change la donne en permettant d’exécuter ces étapes sur une plateforme unique ou distribuée. Grâce au support logiciel (NVIDIA Omniverse, NVIDIA AI Enterprise, vGPU), il devient possible de synchroniser la modélisation, la visualisation et l’IA dans un même flux.
Atelier Archéa a testé un pipeline où les concepteurs travaillent localement sur des scènes lourdes, tandis que des instances serveur exécutent des rendus haute-fidélité et des simulations d’éclairage. La partition du GPU via MIG permet d’allouer des fractions de 24 Go pour des tâches spécifiques, maximisant l’utilisation de la ressource sans compromettre la sécurité des modèles et des données.
Le recours à des fournisseurs cloud dotés de RTX PRO 6000 (AWS, Google Cloud, Azure, CoreWeave, etc.) ouvre des possibilités de montée en charge ponctuelle. Plutôt que d’acheter capacité pour les pics, une agence peut contracter des instances dédiées pour les phases intenses de rendu, puis revenir à un parc local optimisé pour la production quotidienne.
Un autre avantage opérationnel est la virtualisation graphique. En transformant une machine puissante en plusieurs postes virtuels, le studio peut mutualiser l’investissement et offrir à des collaborateurs distants une expérience de modelisation fluide, tout en conservant la maîtrise des licences et des ressources. La sécurité joue aussi un rôle central : les éditions serveurs intègrent des mécanismes avancés pour protéger modèles et données sensibles pendant l’exécution.
Enfin, intégrer des jumeaux numériques liés au BIM devient plus accessible : la capacité mémoire et la bande passante des GPU permettent de tenir des modèles complexes en mémoire, d’exécuter des simulations thermiques et acoustiques en parallèle et d’alimenter des interfaces immersives pour les clients.
Insight : repenser le workflow autour d’un mélange de stations locales équipées de RTX série 6000 et d’instances cloud permet d’équilibrer coûts, sécurité et agilité opérationnelle.
Cas d’usage concrets : rendu architectural, IA générative et simulation physique en production 🧪
Plusieurs acteurs du marché ont déjà montré comment exploiter ces GPU pour aller au-delà de la simple image fixe. Des solutions comme OctaneRender optimisées pour les GPU RTX PRO 6000 permettent d’exécuter des traceurs de trajectoire et des modèles de rendu neuronal sur de grandes scènes, ce qui donne la possibilité de mélanger rendu classique et génération IA pour obtenir des résultats photoréalistes plus vite.
La société OTOY, par exemple, a adapté OctaneRender pour tirer parti des 96 Go de mémoire, ce qui permet aux artistes de charger des assets volumineux et d’appliquer des modèles neuronaux complexes dans le pipeline de rendu. Pour l’architecture, cela se traduit par la capacité à traiter des villes entières en haute résolution pour des études d’ensoleillement et des simulations d’impact visuel.
Un autre exemple pertinent est l’usage de modèles d’IA générative pour créer des variantes de façades, textures ou aménagements paysagers. Black Forest Labs a démontré que l’inférence multimodale se déroulant sur RTX PRO 6000 diminue fortement la latence sur les workflows de génération d’images, ce qui ouvre la voie à des sessions interactives où un concepteur demande des déclinaisons et obtient des propositions exploitables en quelques secondes.
Les labouratoires spécialisés en simulation utilisent aussi ces GPU pour accélérer des calculs physiques (ventilation, acoustique, dynamique des structures) couplés à des algorithmes d’optimisation. Là encore, réduire le temps de calcul change la nature même de la prise de décision : on passe d’un flux séquentiel à des boucles d’optimisation en quasi-temps réel.
Insight : les usages démontrent que la combinaison de visualisation 3D et d’IA sur la série 6000 crée des workflows exploitables dès les phases conceptuelles, offrant un avantage compétitif tangible en phase de conception et de présentation client.
Choisir, déployer et maintenir une flotte basée sur la GPU NVIDIA RTX série 6000 : recommandations pratiques ⚙️
Choisir la bonne configuration demande de l’analyse : usage predominant (rendu vs simulation vs IA), besoins en mémoire, contraintes thermiques et stratégie cloud. Pour Atelier Archéa, la décision a reposé sur trois critères : mémoire suffisante pour les scènes complexes, capacité de partitionnement pour la mutualisation et compatibilité logicielle avec Omniverse.
Sur le plan matériel, noter quelques points concrets : la nouvelle interface d’alimentation 12VHPWR (connecteur 16 broches) devient la norme pour ces cartes haute puissance. Il est possible d’utiliser des adaptateurs 2 x PCIe 8 broches vers 1 PCIe 16 broches fournis par certains fabricants, mais il convient de vérifier la compatibilité de l’alimentation pour éviter des instabilités.
Autre considération : NVLink est moins central sur certaines versions récentes. Cela implique de repenser l’architecture de grille si l’objectif était de coupler plusieurs GPU au sein d’un même processus mémoire partagé. À la place, il faut envisager des architectures distribuées avec un logiciel qui orchestre les tâches.
Du point de vue logiciel, penser au licensing (vGPU), à la sécurité des modèles (Confidential Computing) et à la maintenance des drivers. La robustesse d’un parc dépend autant de procédures opérationnelles claires que de la performance brute des cartes. Planifier des tests de charge, définir des seuils d’obsolescence et prévoir la montée en charge via le cloud sont des étapes indispensables.
Insight : une migration réussie vers la série 6000 passe par une approche systémique — matériel, logiciel, organisation — qui transforme l’investissement en levier stratégique plutôt qu’en simple mise à niveau technologique.

