Datacenters et Edge Computing : pourquoi la décentralisation devient indispensable pour l’industrie
La transformation numérique des sites industriels pose une question simple mais lourde de conséquences : comment traiter des volumes massifs de données produits en continu par des capteurs et des machines sans saturer les réseaux ni perdre en réactivité ? La réponse qui s’impose aujourd’hui consiste à rapprocher le calcul des sources : Edge Computing et données décentralisées ne sont plus des concepts théoriques, mais des leviers opérationnels.
Dans mes observations sur le terrain, la tension principale vient de la combinaison de l’augmentation du trafic IoT et des exigences d’analyse en temps réel. Les usines qui se sont appuyées jusqu’ici sur un modèle cloud centralisé ont vite constaté des limites : délais de transfert, coûts croissants de bande passante, et difficulté à garantir une continuité de service lors d’une coupure réseau. Ce constat vaut pour des PME industrielles comme pour des groupes internationaux.
Le principe est simple à énoncer : au lieu d’envoyer toutes les données vers des serveurs éloignés, le traitement local s’effectue au plus près des machines, sur des passerelles, des micro-datacenters ou des serveurs embarqués. Ce rééquilibrage réduit mécaniquement la latence et la quantité d’informations à transmettre vers le cloud. Gartner avait chiffré l’ampleur du phénomène en annonçant que la part des données traitées en périphérie devait fortement croître d’ici 2025, ce qui confirme une trajectoire déjà engagée dans l’industrie.
Pour donner vie à ces idées, prenons l’exemple fictif d’une PME de mécanique, baptisée ici Atelier Durand. Face à des arrêts de production coûteux, l’équipe a choisi d’installer des passerelles edge pour prétraiter les signaux de vibration et de température. Résultat : les alertes critiques sont générées localement et les interventions planifiées évitent des pannes longues. Cette approche montre que l’Edge n’est pas une option réservée aux géants de la tech, mais une stratégie accessible et rentable pour des structures de taille intermédiaire.
Sur le plan économique, la logique est claire : en limitant le transfert des flux bruts vers le cloud, on réduit la consommation de bande passante et les coûts associés. Des études du secteur ont même estimé des réductions significatives des dépenses d’hébergement cloud lorsque le prétraitement s’opère à la périphérie. En pratique, on compresse, on filtre, on agrège localement, puis on n’envoie vers le cloud que ce qui est pertinent pour des analyses historiques ou pour l’entraînement de modèles.
Enfin, la proximité du calcul change aussi la donne en termes de souveraineté et de conformité. Traiter des données sensibles à l’intérieur d’un site industriel permet de mieux contrôler qui y accède et comment elles sont stockées, un argument devenu central dans les stratégies industrielles depuis l’apparition de régulations renforcées sur la sécurité des réseaux. 🔒
Insight clé : rapprocher le calcul des machines est une réponse pragmatique aux défis de l’industrie 4.0, qui réduit la latence et le coût des flux tout en renforçant la maîtrise des données.
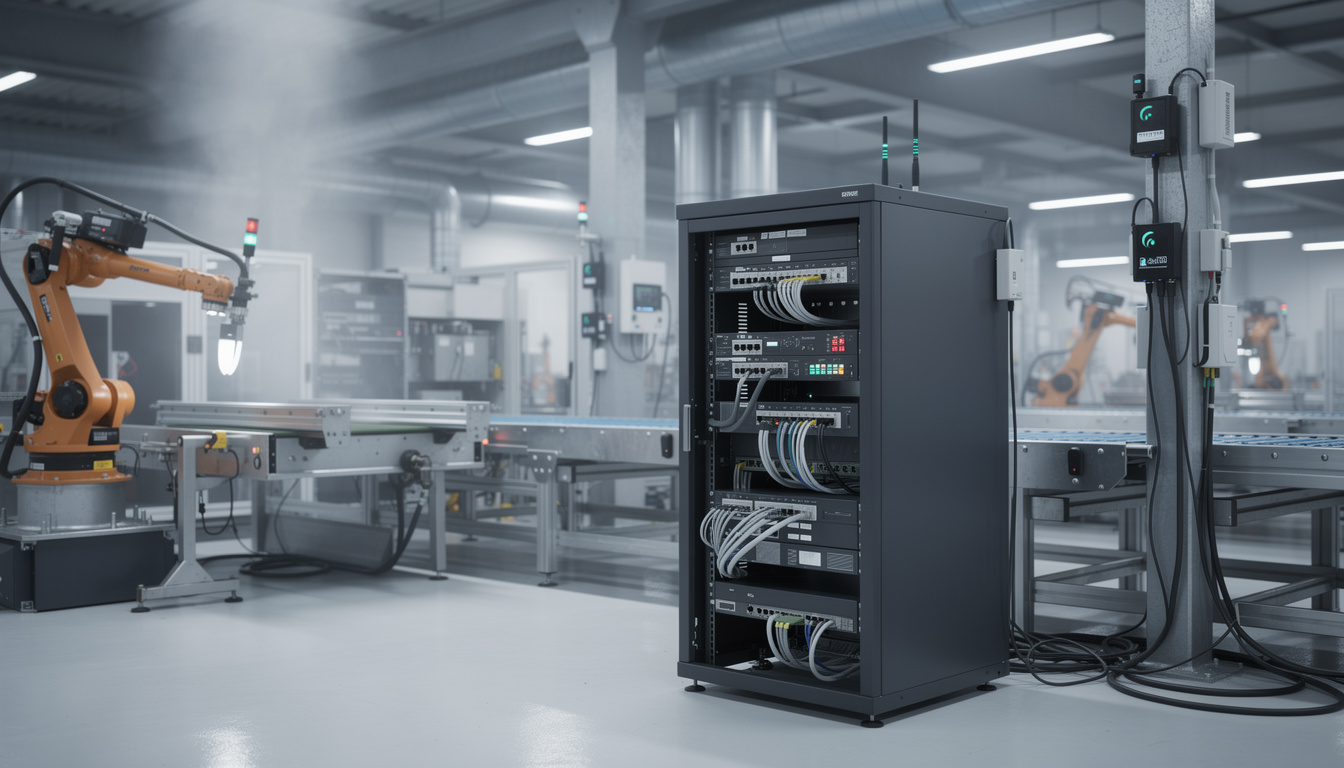
Le principe du traitement local : fondements techniques et architecture pour l’industrie 4.0
Comprendre le Edge Computing passe par la clarification de ses fondements. Trois principes structurent l’approche technique : la localité, l’autonomie des nœuds et la hiérarchisation des traitements. Ces principes déterminent ce qui sera exécuté sur site, ce qui restera en périphérie et ce qui sera confié au cloud central pour des analyses longues ou de l’archivage.
Localité et autonomie : pourquoi traiter au plus près change tout
La localité signifie que certaines décisions doivent être prises immédiatement, sans aller chercher l’approbation d’un centre distant. Dans des lignes de production critiques, l’acceptation d’un temps de latence même faible peut entraîner un défaut produit ou un incident. Traiter les données sur des passerelles edge ou des serveurs locaux garantit une latence réduite et une capacité de réaction instantanée.
L’autonomie est la capacité des nœuds à fonctionner même si la connexion au cloud est interrompue. Ceci est essentiel dans des sites isolés ou lorsqu’une maintenance réseau impose une coupure temporaire. Les nœuds edge capables d’exécuter des règles métier et des modèles d’IA locaux limitent l’impact opérationnel des interruptions.
Hiérarchisation des traitements et orchestration
Tous les traitements ne se valent pas : certains nécessitent une latence minimale, d’autres des ressources de calcul importantes. La hiérarchisation permet d’assigner chaque tâche à l’échelon adapté — capteur, passerelle, micro-datacenter régional, cloud. Pour orchestrer cela, les entreprises adoptent des outils modernes de conteneurisation et d’orchestration, avec des technologies comme Kubernetes adaptées à des environnements hétérogènes.
Cette transformation logicielle impose un changement de culture : les applications se conçoivent désormais de manière modulaire pour pouvoir être déployées et mises à jour indépendamment sur des nœuds variés. C’est un mouvement proche de l’industrialisation des microservices, dont on trouvera des bonnes pratiques dans des ressources dédiées comme architecture microservices scalable, qui éclaire la mise en place d’architectures distribuées robustes.
Infrastructures périphériques : micro-datacenters et gateways
Sur le plan matériel, l’Edge s’appuie sur des micro-datacenters compacts et des edge gateways capables de collecter, agréger et prétraiter des flux IoT. Ces éléments sont conçus pour des environnements industriels réels : tolérance aux vibrations, températures variables et contraintes d’espace. Leur déploiement est aujourd’hui industrialisé, avec des racks renforcés et des systèmes de refroidissement adaptés.
L’optimisation réseau est un sujet connexe : la topologie doit permettre une circulation fluide entre capteurs et nœuds locaux, avec des mécanismes de qualité de service pour prioriser le trafic critique. C’est ici qu’intervient la notion d’infrastructure distribuée, qui ne se limite pas à multiplier des points de calcul, mais à créer un maillage cohérent entre eux.
Enfin, dans la pratique, il est courant d’utiliser des solutions hybrides : le traitement local pour les besoins immédiats et le cloud pour l’agrégation à long terme. Pour approfondir l’organisation des services distribués et les déploiements modulaires, il vaut la peine de consulter des guides techniques tels que guide sur l’architecture microservices scalable. 📘
Insight clé : une architecture edge réussie repose sur une orchestration intelligente entre couches locales et centrales, avec des micro-services pensés pour être déployés à la périphérie.
Avantages opérationnels : maintenance prédictive, optimisation réseau et analyse en temps réel
Les bénéfices concrets du Edge Computing se mesurent dans la réduction des arrêts non planifiés, l’amélioration de la qualité produit et l’efficience des flux logistiques. L’analyse en temps réel sur site permet de détecter des anomalies avant qu’elles n’entraînent une panne et de piloter la production en fonction des conditions réelles.
Un cas souvent cité est la maintenance prédictive : en agrégeant localement les mesures de vibration, température et courant, un algorithme déployé en périphérie peut estimer la dégradation d’un roulement et déclencher une intervention planifiée. General Electric et d’autres acteurs industriels ont démontré la valeur de cette démarche en réduisant fortement les temps d’arrêt non planifiés.
La réduction de la latence a des conséquences directes sur la qualité du contrôle. Dans certaines chaînes où la fenêtre d’intervention se compte en millisecondes, une transmission vers un cloud lointain serait impraticable. Le traitement local permet de garder ces boucles de contrôle ouvertes et fiables.
Sur l’optimisation réseau, l’impact est également tangible. Prétraiter les données à la source évite d’envoyer des flux bruts sur des réseaux parfois coûteux. Des expérimentations industrielles montrent que l’on peut réduire jusqu’à 80-95% du trafic envoyé au cloud en ne transmettant que des événements ou des résumés analytiques. Ce filtrage local se traduit par des économies directes sur les coûts de connectivité.
Pour une PME comme Atelier Durand, ces gains sont cruciaux. Après avoir déployé une solution edge pour surveiller ses presses et ses tours, l’entreprise a vu les consommations réseau baisser tandis que la disponibilité des lignes augmentait. Le coût initial du déploiement a été amorti grâce à la baisse des interventions d’urgence et à l’optimisation des consommations énergétiques.
Par ailleurs, le double modèle (edge + cloud) permet d’équilibrer les charges : les modèles d’IA peuvent être entraînés dans le cloud avec de larges historiques, puis déployés en version optimisée sur les nœuds périphériques pour une exécution rapide. Tesla illustre ce principe dans les véhicules : un traitement embarqué pour la réactivité, soutenu par un cloud central pour l’entraînement à grande échelle.
L’aspect énergétique mérite une mention : moins de transmissions signifie aussi moins d’énergie consommée par le réseau. Des micro-datacenters bien conçus peuvent même valoriser la chaleur rejetée et réduire l'empreinte carbone globale d’un site industriel. 🌍
Insight clé : le passage par l’edge se traduit par des gains opérationnels mesurables — moins d’interruptions, des réseaux moins sollicités et une réactivité améliorée — autant d’arguments qui pèsent dans une décision d’investissement.
Sécurité des données et résilience : gérer les risques dans une infrastructure distribuée
La multiplication des points de traitement élargit naturellement la surface d’attaque et complexifie la gestion de la sécurité. Pourtant, traiter localement peut aussi renforcer la protection des informations sensibles si la stratégie est bien pensée. La clé réside dans la combinaison d’un chiffrement robuste, d’une gestion fine des identités et d’une posture de type Zero Trust.
En pratique, chaque nœud edge doit être considéré comme potentiellement hostile. L’utilisation d’attestations à distance permet de vérifier l’intégrité d’un équipement avant de lui confier des données sensibles. Le chiffrement des données au repos et en transit est indispensable, ainsi que des mécanismes de rotation et de révocation des certificats adaptés à un environnement distribué.
La directive NIS 2 et les exigences sectorielles renforcées poussent les industriels à formaliser leurs architectures de sécurité. Schneider Electric a démontré l’intérêt d’intégrer des fonctions edge dans des systèmes SCADA pour limiter l’exposition des données critiques et réduire les chemins d’attaque. Cette logique s’accompagne d’un durcissement physique des équipements déployés sur site afin de prévenir les manipulations directes.
La gestion des identités reste un défi majeur : il faut concilier robustesse cryptographique et contraintes matérielles des passerelles. Des approches émergentes comme les identités auto-souveraines et les enclaves de calcul sécurisé (confidential computing) offrent des solutions adaptées. Elles permettent de traiter des données sensibles dans des environnements potentiellement non fiables tout en conservant des garanties fortes sur la confidentialité.
Un autre angle à considérer est la résilience opérationnelle : une infrastructure distribuée favorise une meilleure tolérance aux pannes. Si un nœud tombe, les autres peuvent prendre le relais ou maintenir un fonctionnement dégradé acceptable. Cette capacité est essentielle pour des sites critiques ou isolés.
Néanmoins, la coordination centralisée des politiques de sécurité reste nécessaire. Des plateformes d’orchestration et de supervision permettent d’uniformiser les règles et d’automatiser les mises à jour de sécurité. De plus, la visibilité sur l’ensemble du parc edge est indispensable pour détecter les anomalies et réagir rapidement. 🔍
Insight clé : la décentralisation exige une révision de la posture sécurité — plus d’attention sur l’authentification, le chiffrement et l’attestation des nœuds, mais aussi une opportunité pour renforcer la résilience des services industriels.
Impacts socio-économiques et modèles d’avenir : souveraineté, maillage territorial et orchestration hybride
Au-delà des bénéfices techniques, la montée du Edge Computing redessine des équilibres économiques et territoriaux. En rapprochant le traitement des données des lieux de production, les entreprises et les collectivités regagnent une partie de leur souveraineté numérique. Cela a des conséquences directes sur les politiques d’investissement et sur la manière dont les ressources numériques sont distribuées sur un territoire.
Des pays européens ont intégré l’edge dans leur stratégie de souveraineté, notamment pour protéger des secteurs critiques. Ce mouvement favorise l’émergence d’acteurs régionaux qui proposent des infrastructures distribuées adaptées aux besoins locaux. Ces acteurs complètent l’offre des hyperscalers en proposant de la proximité et une meilleure maîtrise réglementaire.
L’effectivité de cette transformation passe par des modèles économiques innovants. La mutualisation des infrastructures edge entre plusieurs entreprises ou services apparaît comme un levier de viabilité. Des places de marché pour la capacité de calcul en périphérie commencent à émerger, facilitant une allocation dynamique des ressources et offrant une alternative aux modèles entièrement centralisés.
La question de l’équité territoriale reste cependant posée. Sans intervention publique ou incitations, le déploiement suivra les logiques de rentabilité et risque d’accentuer les fractures numériques. Des politiques de soutien ciblées peuvent encourager l’installation de micro-datacenters dans des zones moins desservies, créant des emplois locaux et renforçant l’attractivité industrielle des territoires.
Sur le plan technique, l’avenir se dessine plutôt dans une orchestration hybride que dans une substitution totale du cloud par l’edge. L’idée d’une « symphonie distribuée » — où capteurs, passerelles, micro-datacenters et clouds coopèrent — est déjà mise en œuvre via des initiatives d’open standardisation comme EdgeX Foundry. Cette approche facilite l’interopérabilité et réduit la fragmentation du marché.
Enfin, la gouvernance des données devient centrale : qui décide quelles données restent locales et lesquelles peuvent être partagées ? Les réponses varieront selon le secteur et les enjeux réglementaires. Pour les industriels, la règle de bon sens reste d’aligner la stratégie technologique avec les objectifs business, la sécurité et la conformité.
Insight clé : la décentralisation ouvre des opportunités économiques et territoriales majeures, mais demande une orchestration intelligente et des politiques publiques pour garantir une diffusion équitable des bénéfices.

